-
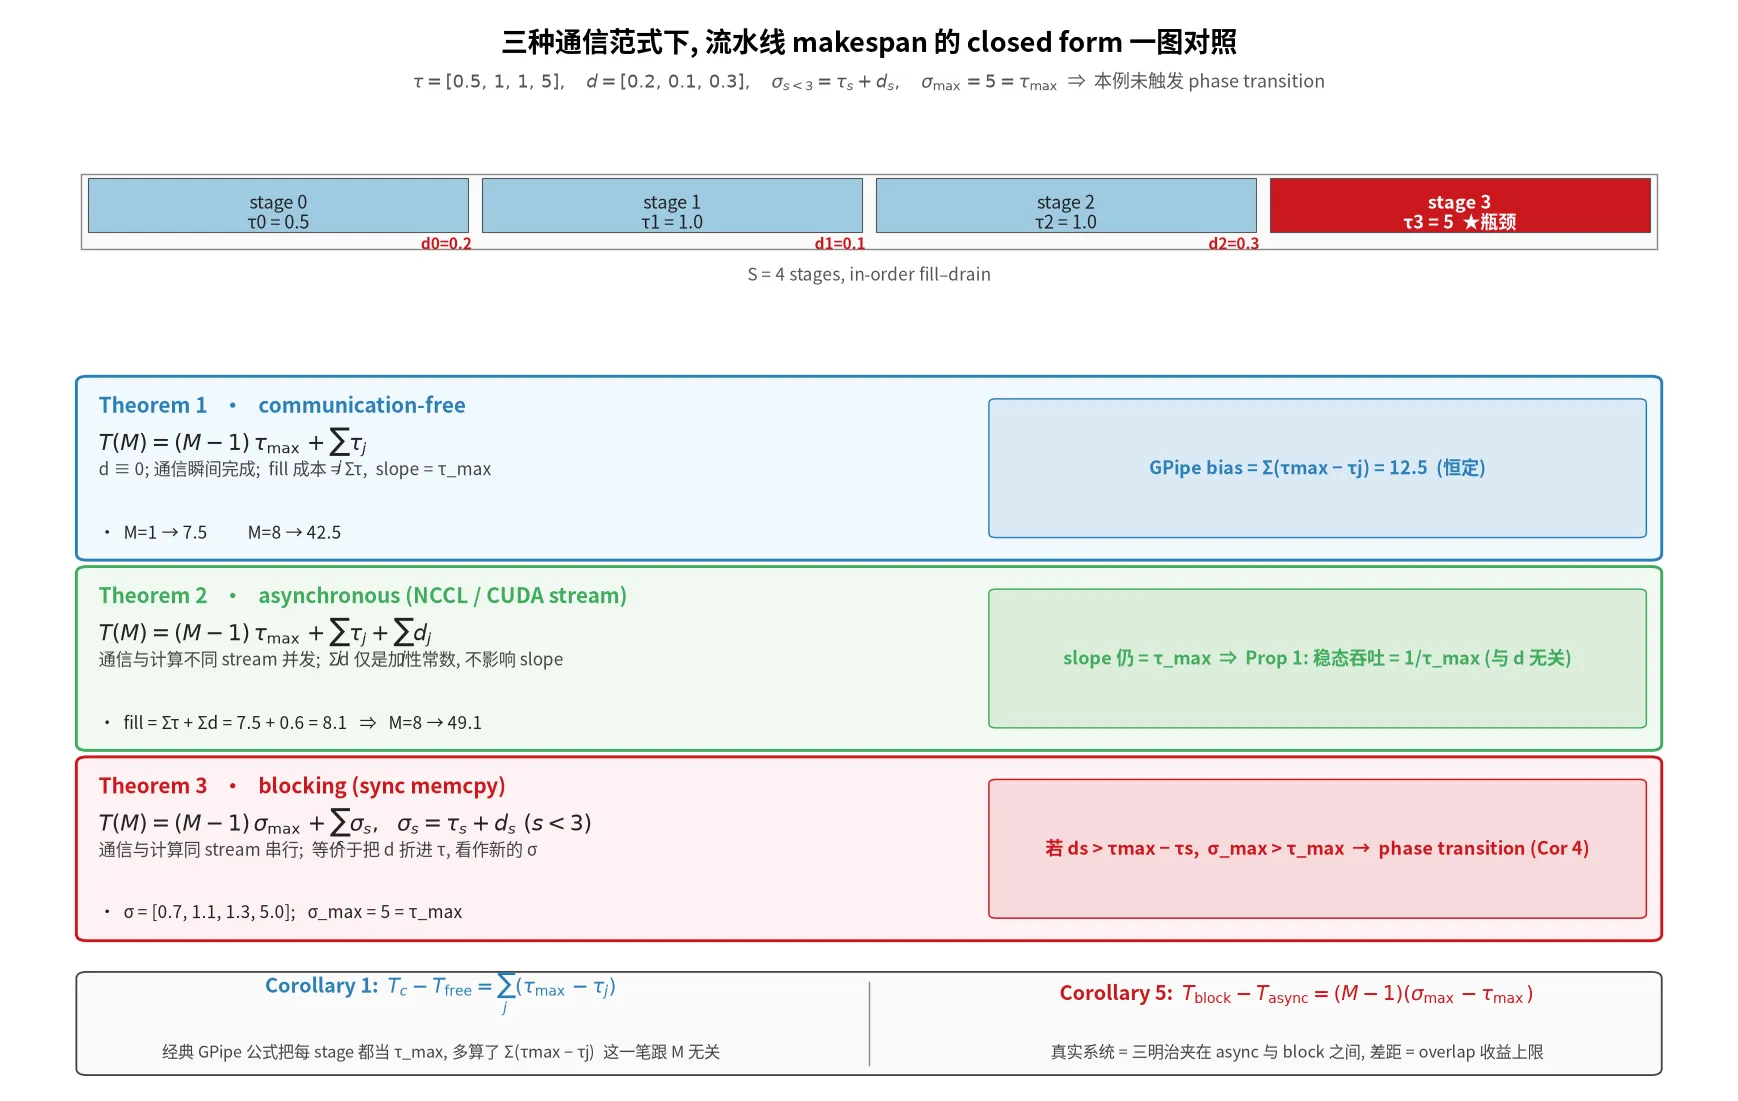 [论文解读] 异构 LLM 推理流水线的精确 makespan:为什么 GPipe 公式会系统性高估两倍
arXiv 2610.21815:异构 LLM 推理流水线在三种通信范式下的精确 closed-form makespan,证明 GPipe 同质偏置可分解为恒定 overestimate 与通信 underestimate,给出通信进入稳态斜率的相变条件,改写自动并行分区器的优化优先级。
26 min - 深入解析 TokenSpeed:LightSeek 把 LLM 推理引擎拆成"控制面 + 执行面"到底解决了什么
lightseekorg/tokenspeed 47MB / 85K 行 / 12 状态 FSM。控制面 C++ 状态机 + 执行面 Python + 可插拔 kernel + Blackwell 最快 MLA decode,这套拆法值得每个撸推理引擎的人读完。
30 min - [论文解读] Same Query, Different Answer:语义查询在重复执行之间为什么不稳
arXiv 2610.13823 来自 IBM。1.2M 次模型调用证明 temperature 0 不等于确定性,item 翻动 0.07%~24%,plan 算子指数级放大,质量分藏住一半以上答案变化;附 7+5 条 benchmark 报告与引擎设计建议。
26 min - 深入解析 airllm:70B / 671B / 2.8T 模型是怎么跑进 4GB 显存的
lyogavin/airllm 38K stars,3500 行 Python。meta 空壳 + forward hook 临时驻 GPU + 预取下一层 + per-expert 流式,让 70B/671B/2.8T 模型跑进单卡 4GB 显存,完整保留 transformers 推理路径,新架构当日支持。
23 min
Back